01 / STORAGE BASE
AI SSD
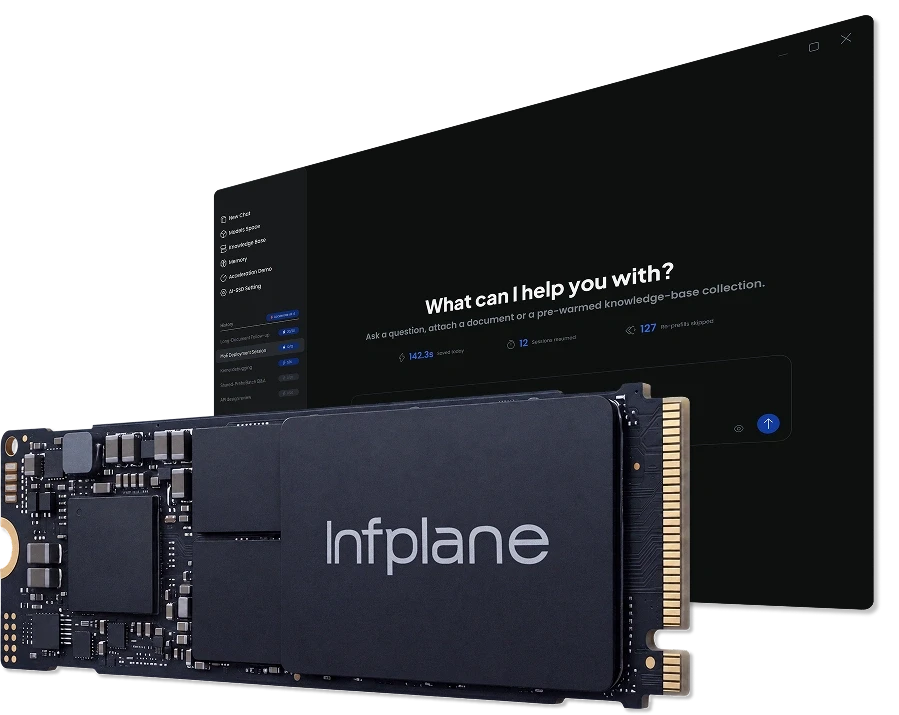
标准 M.2 形态,
接在现有平台上
面向本地 AI 工作负载的 PCIe 4.0 / 5.0 NVMe 固态硬盘。它首先是一块能装进现有机器的硬盘,其次才参与模型数据的调度。
M.2 2280Form factor
PCIe 4.0/5.0Interface
本地 AI 落不了地,大多数时候不是模型的问题。 是这台机器装不装得下,几个人同时用, 以及断网之后它还跑不跑。
显存加内存的可用总量决定能装多大的模型。这个数不够,参数怎么调都没用;这个数够了,换盘不会让单次生成变快。
一个人用得顺,三个人排队是两件事。并发上来之后,KV Cache 放哪里,决定首字延迟,也决定要不要加盘。
型号、内存、模型、量化方式、使用人数,逐项落到配置单上。到货前拉一台同配置机器跑一遍,数字连同条件一起给。
面向本地 AI 工作负载的 PCIe 4.0 / 5.0 NVMe 固态硬盘。它首先是一块能装进现有机器的硬盘,其次才参与模型数据的调度。
预测并预取 MoE 数据块,用 NAND 容量补充有限的 DRAM 与 VRAM。权重装不下的机器,先解决的是能不能跑,不是跑多快。
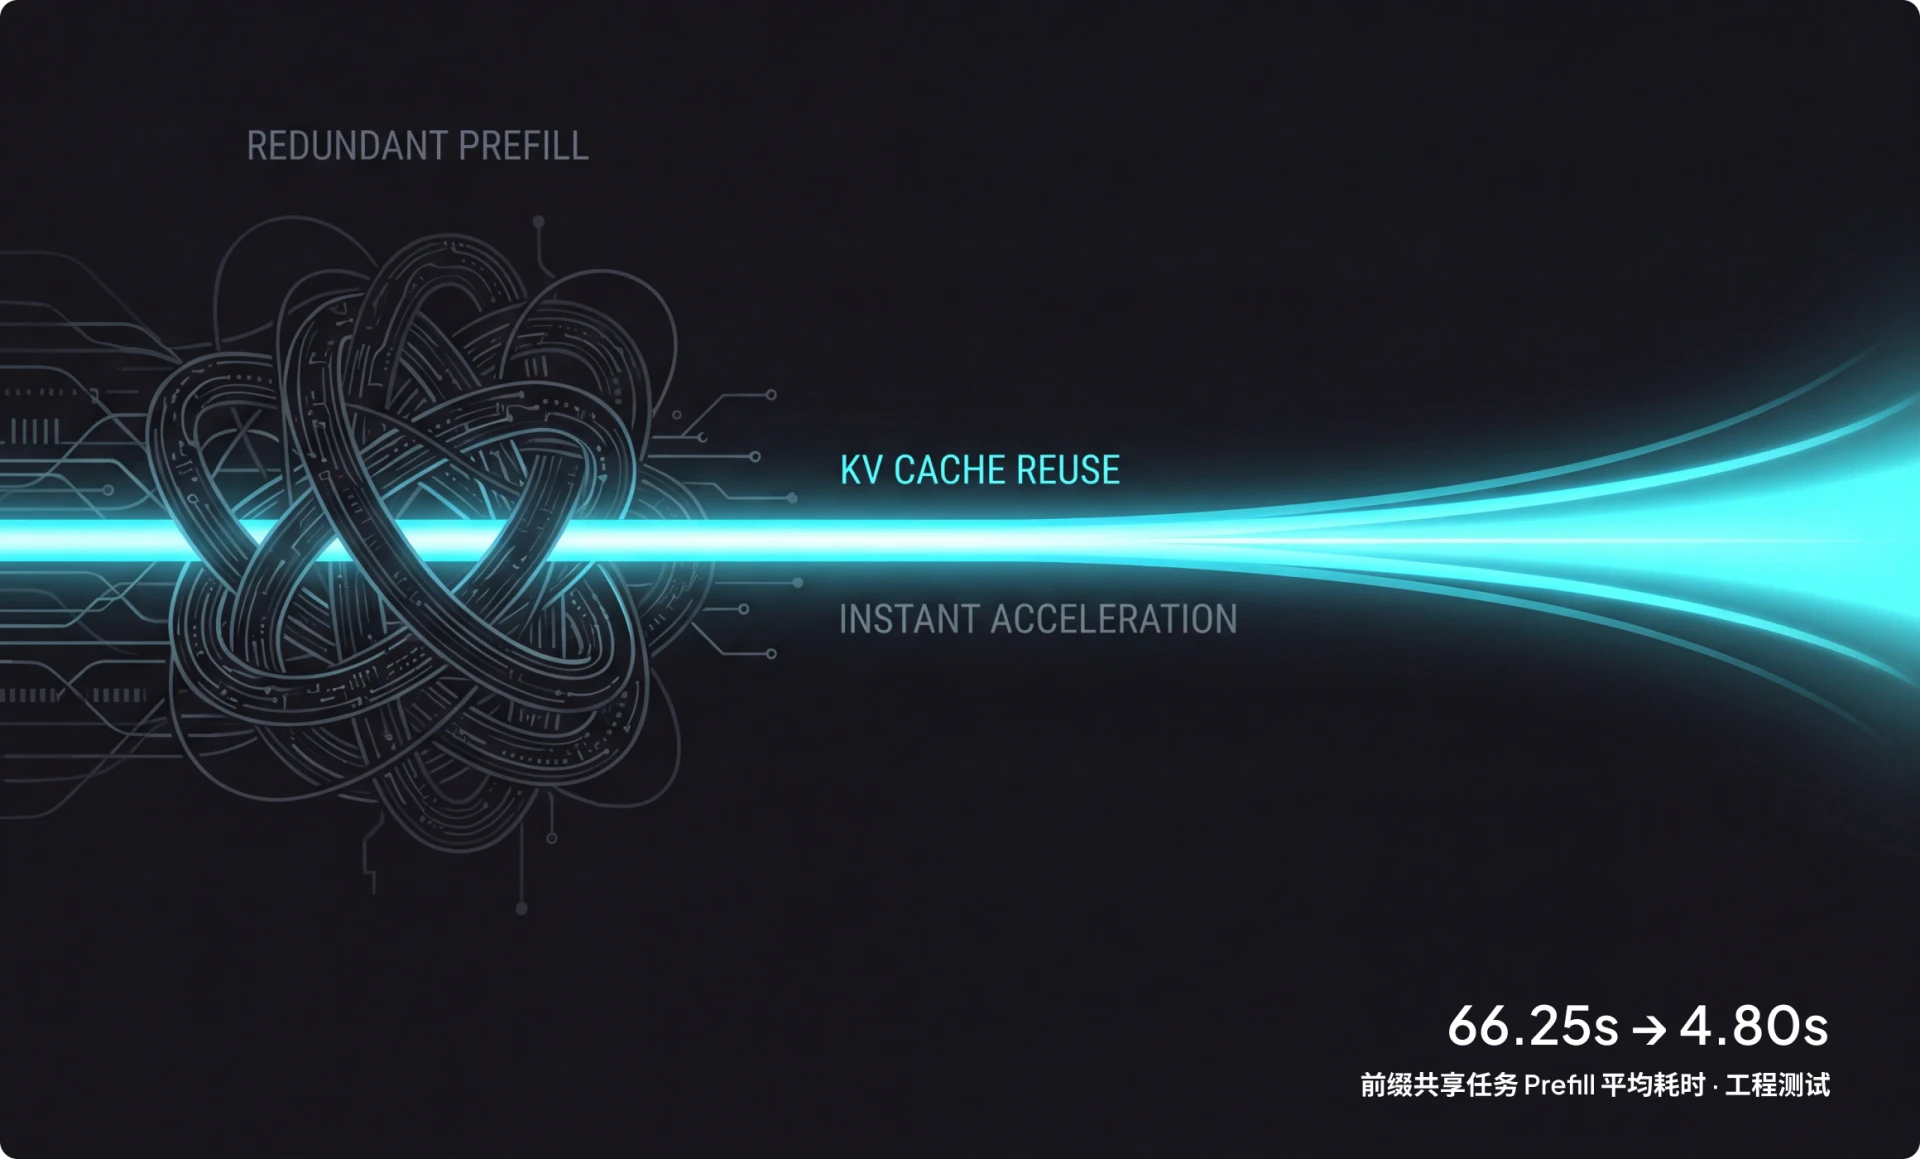
复用 KV Cache,减少 Prefill 阶段的重复计算。长上下文与多轮对话省下的是重算时间;多人同时使用时,它抬高的是并发上限。
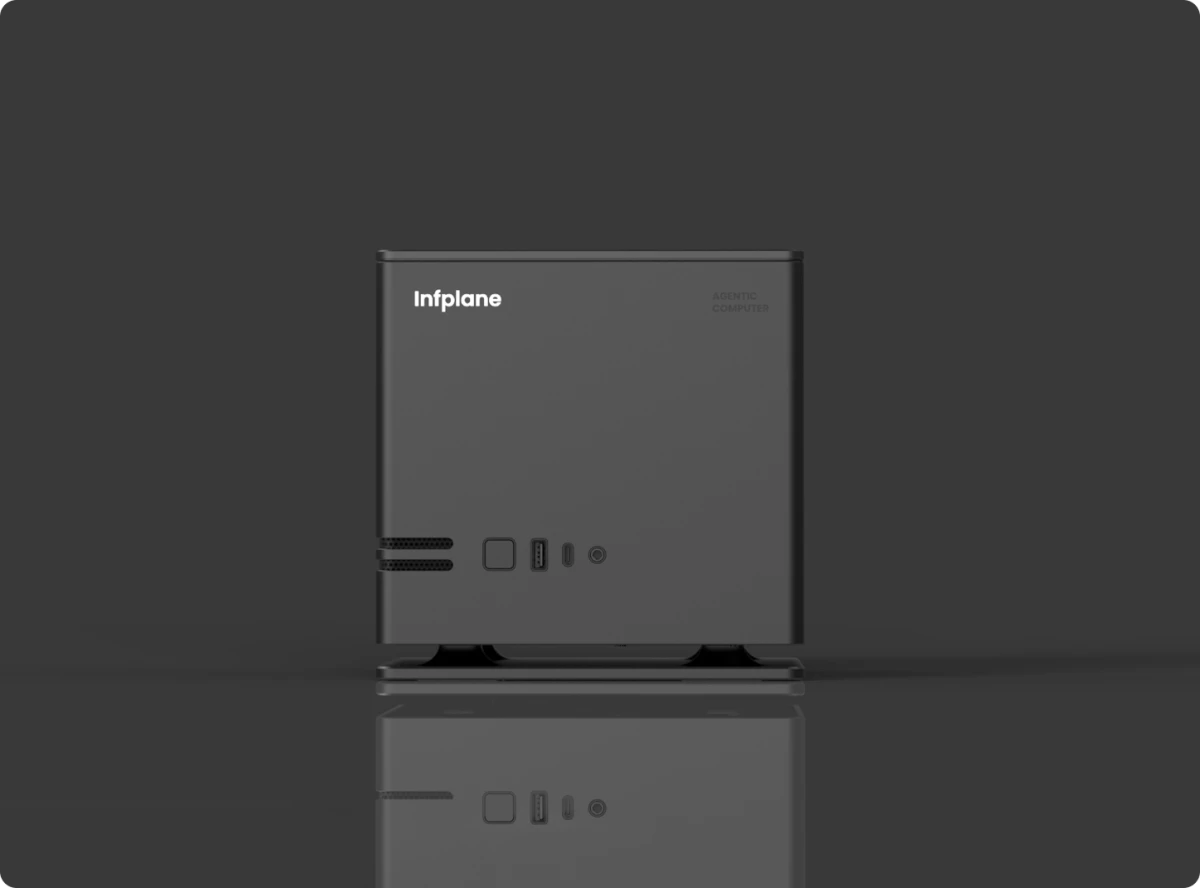
个人工作站,服务器级带宽。128GB 统一内存把原本要靠多卡堆出来的容量,收进一台 ITX 机箱里。
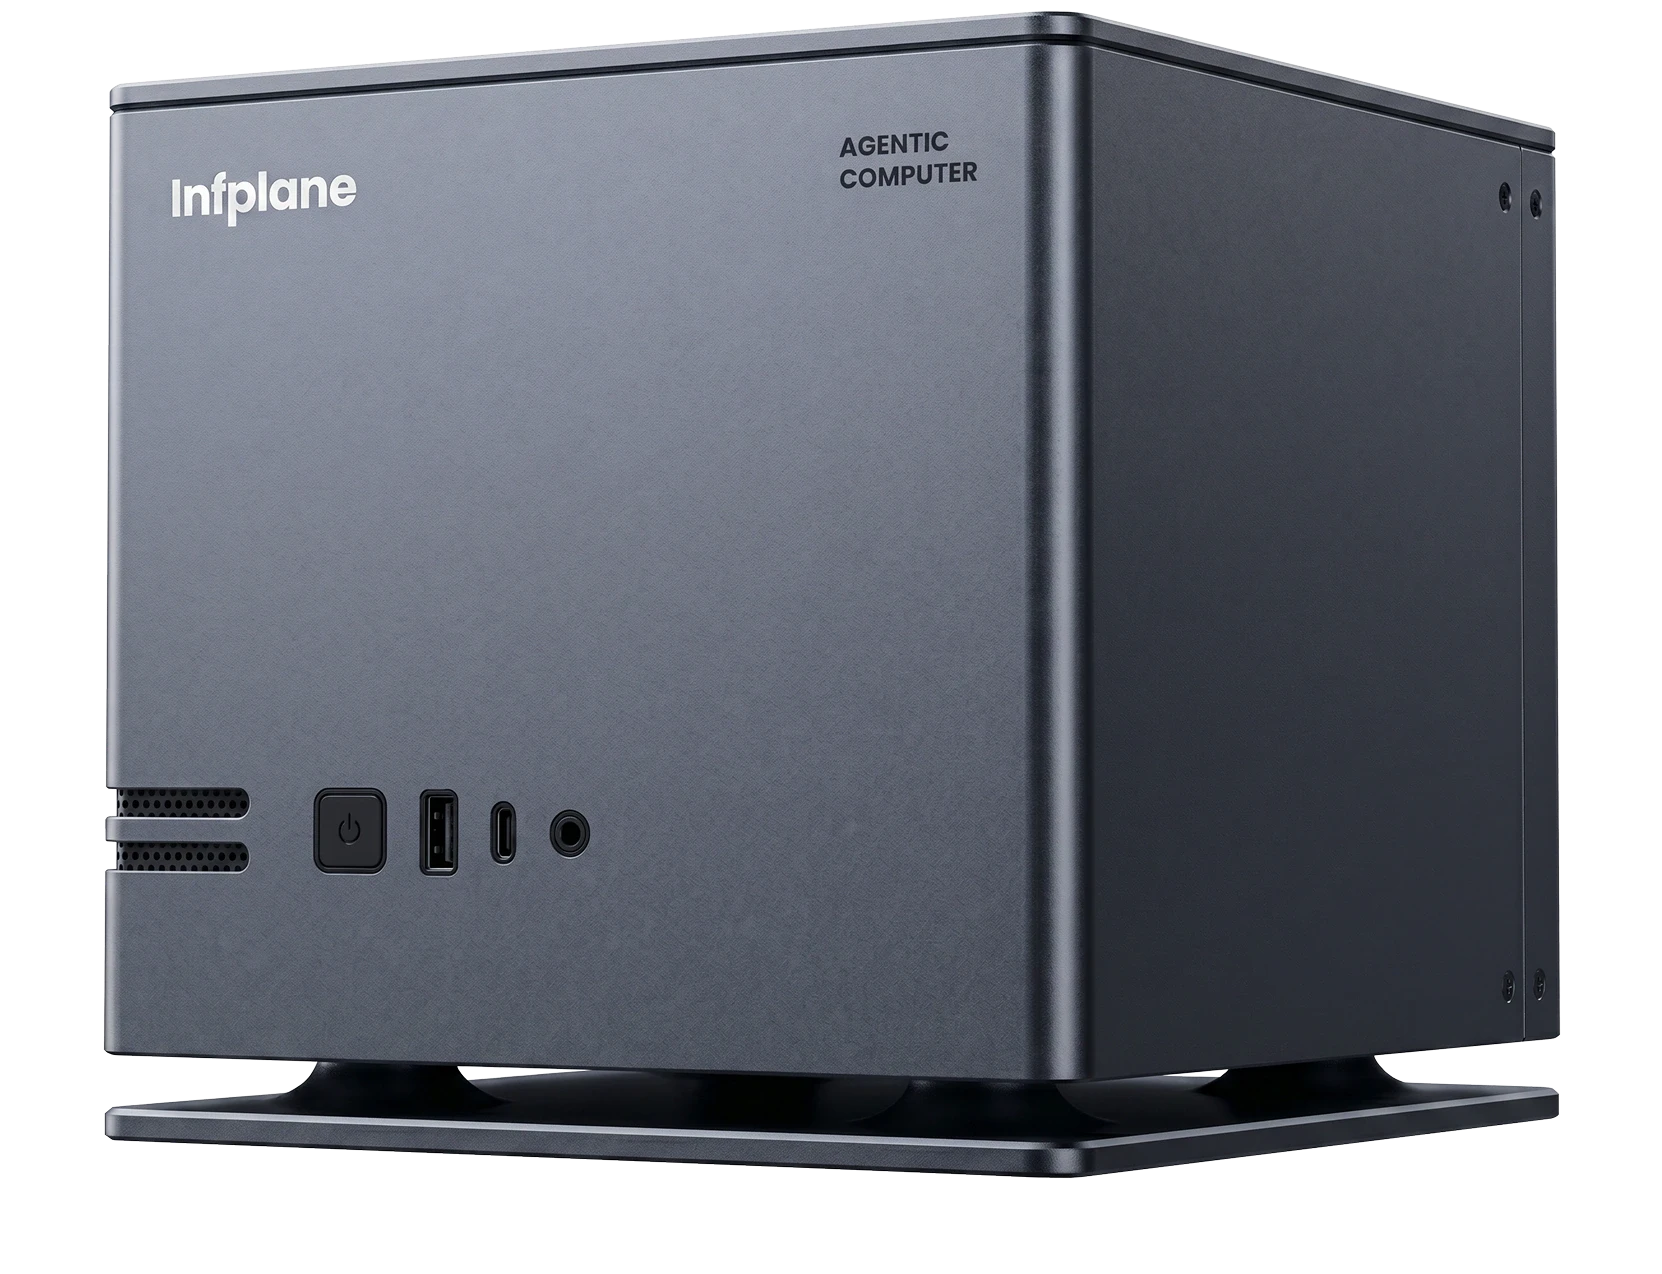
16 核 32 线程,集成 Radeon 8060S,128GB 统一内存。约 96GB 可划给 GPU 当显存,模型权重、上下文、多模态模型可以同时留在内存里。
多点覆盖液冷加高功率电源,长时段满载不降频。放在办公桌上,不放进机房。
本地大模型推理、3D 渲染与内容创作、科学计算,同时保留高性能游戏主机与 NAS 能力。KLEENE 固件在底层做功耗与进程调度。
这是我们对客户讲价值的唯一口径:先看权重装不装得下,再看 KV 装不装得下。判断的基准是显存加内存的可用总量,不是只看内存条。
模型加载不进来,或者一加载就爆内存。这时候盘的作用是让模型跑起来——谈的是能不能用,不是每秒多少字。
短对话正常,上下文一长就崩,或者第二个人进来就排队。盘扩的是上下文长度与并发数,收益来自 KV 换出与复用。
需要跨请求复用、快速切换模型、保留智能体记忆。这时候盘省的是重算时间。都装得下又只跑单请求,我们直接说不用买。
同一个平台,四种用法。演示的时候不用讲通用话术,直接按你的场景出题。
机房断网、数据不出校。一个班同时提问,模型留在本地;课件、题库、学生数据不上传。
内网部署,涉密资料不出机房。智能体读内部文档、写材料、做检索,全部在本机完成。
出图、改图、配音、剪辑,模型和素材都在本地。不按次计费,不怕把客户素材传到别人服务器上。
Coding Agent 长时间跑,上下文和记忆持续增长。KV 与记忆落在盘上,人不用守着,账单也不按 token 涨。
下表为单机实测记录,同一模型、同一量化文件、同一软件栈。数字给区间不给单点;进客户合同前,按客户机器重跑一遍。
| 模型 / 量化 | 显存 + 内存 | 加速盘 | 逐字速度 | 备注 |
|---|---|---|---|---|
| 122B · Q2_0 | 16GB + 32GB | 寅谱 AI SSD | 45.3 tok/s | 单卡 |
| 122B · Q2_0 | 32GB 双卡合计 | 寅谱 AI SSD | 60.7 tok/s | 双卡 |
| 122B · IQ3_S | 16GB 单卡 | 寅谱 AI SSD | 15.5 tok/s | 需盘驻留 |
| 122B · IQ3_S | 32GB 双卡 | 寅谱 AI SSD | 27.5 tok/s | 需盘驻留 |
| 35B · Q4 | 16GB 单卡 | 寅谱 AI SSD | 53.7 tok/s | 权重可驻留 |
| 428B · IQ1 | 32GB 双卡 | 寅谱 AI SSD | 6.7 tok/s | 输出退化,不推荐 |
测试口径:Windows / Linux 单机,llama.cpp 系推理引擎,上下文长度与批大小固定;每组三次取中位,组内变异小于 2%。
未标注实测的配置为按容量比推算,误差可能达 ±30%。换更快盘在同条件下冷启动约 1.2 倍,热态差异很小——盘影响的是冷态,不是持续生成速度。
不先卖货,先核配置。四步走完,客户手里应该有一张能自己复核的对照表。
客户现有机器型号、显卡、内存、要跑的模型、量化方式、同时使用人数。清单填完,能不能跑、要不要盘,当场就有答案。
拔网线,用客户自己的题、自己的文档跑一遍。并发开到客户真实人数,让排队和延迟暴露在现场,而不是等到验收。
装盘、分区、配推理引擎参数、接客户端。把上下文长度、并发数、KV 策略按客户实际负载定下来,写进交付文档。
一线响应、二线方案、备件换新的时限在合同里写清楚。客户第一个问题不是谁负责,是多久能好。
旺诚谷科技是寅谱(Infplane)AI 计算产品的渠道与交付服务商,负责 AI SSD 与 Hilbert 桌面超算的选型、演示、部署与售后。
寅谱做的是让存储参与 AI 计算:不是让 SSD 替代 GPU,而是让暂时不活跃的模型权重、KV Cache、智能体记忆有地方放,把昂贵的显存和内存留给马上要算的部分。
我们的工作是把这套东西落到具体一台机器上。同一块盘,在不同配置上的价值完全不同——所以我们不做统一话术,也不给单点性能承诺。客户给配置,我们给判断;判断错了,责任在我们。
装得下,我们说不必买;装不下,我们把能跑多大、几个人用、多快,连着测试条件一起写清楚。
机器型号、显卡、内存、要跑的模型、几个人用。清单给全,24 小时内回复:能不能跑、要不要盘、大概多少预算。
也可以直接约现场演示。带一台机器过来,或者我们去你那里,拔掉网线跑一遍——比任何参数表都直接。